
Je voulais intégrer une IA locale à mon Homelab sans transformer mon poste de travail en serveur dédié. L’objectif était simple à formuler : faire fonctionner Ollama et Open WebUI dans des conteneurs Podman rootless, conserver les données sur mon disque Homelab, et exploiter ma NVIDIA GeForce GTX 1650 de 4 Go pour l’inférence.
Dans la pratique, cette installation m’a surtout appris qu’une architecture propre ne se résume pas à faire démarrer deux conteneurs. Il a fallu organiser le stockage, valider l’accès au GPU couche par couche, résoudre une incompatibilité entre Podman et NVIDIA Container Toolkit, puis simplifier la communication entre Open WebUI et Ollama.
Le résultat final est plus simple que certaines de mes premières tentatives : Pop!_OS / COSMIC, Podman rootless, NVIDIA CDI, Ollama, Open WebUI, un réseau dédié ai-net, des données persistantes sous /srv/homelab, et un démarrage à la demande depuis Podman Desktop.

Pourquoi construire mon environnement d’IA locale avec Podman
Ma machine locale fonctionne sous Pop!_OS / COSMIC. Elle me sert à la fois de poste de travail et de laboratoire : navigateur, outils de développement, conteneurs, tests, IA locale et différents projets du Homelab doivent cohabiter.
Je ne voulais donc pas installer une pile d’outils directement dans le système ni laisser une IA monopoliser les ressources en permanence.
J’ai choisi Podman rootless comme moteur de conteneurs. Le principe est important : les conteneurs s’exécutent dans le contexte de mon utilisateur, sans faire reposer toute l’exploitation sur un démon central lancé avec les privilèges root.
Ce choix devait aussi s’intégrer à l’organisation générale du Homelab.
Organiser le stockage avant l’IA
Avant de déployer Ollama ou Open WebUI, j’ai séparé les fichiers de configuration des données persistantes.
Mon organisation repose principalement sur :
/srv/homelab/
├── stacks/
├── data/
└── containers/
Les fichiers Compose sont stockés sous :
/srv/homelab/stacks/Les données applicatives persistantes restent sous :
/srv/homelab/data/Le stockage interne utilisé par Podman rootless a également été déplacé vers le disque Homelab. La configuration utilise un graphroot dédié :
[storage]
graphroot = "/srv/homelab/containers"
Après cette modification, j’ai validé que Podman fonctionnait bien en mode rootless avec le pilote de stockage overlay, puis j’ai lancé un conteneur de test avant d’aller plus loin.
Cette étape peut sembler secondaire, mais elle évite de mélanger les couches. Si un simple conteneur Alpine ne fonctionne pas, il est inutile de commencer à diagnostiquer CUDA ou Ollama.
Deux disques montés automatiquement
Le disque principal du Homelab est monté sur :
/srv/homelabLe disque destiné aux sauvegardes est monté sur :
/srv/homelab-backupJe peux ainsi conserver une architecture stable indépendamment du cycle de vie des conteneurs. Les stacks peuvent être recréées, tandis que les données restent sur l’hôte.
La stratégie de sauvegarde mérite un article distinct ; ici, l’important est que le stockage ait été pensé avant les services.
Le vrai défi : faire fonctionner la GTX 1650 dans Podman
Ma machine dispose d’une NVIDIA GeForce GTX 1650 avec 4 Go de VRAM. Pour une IA locale, cette quantité de mémoire impose naturellement des modèles modestes, mais elle reste suffisante pour expérimenter avec une accélération GPU réelle.
La première validation doit toujours se faire sur l’hôte.
nvidia-smiTant que cette commande ne voit pas correctement la carte graphique et le pilote NVIDIA, il ne sert à rien d’accuser Podman.
Une fois le GPU validé côté système, il reste encore plusieurs couches :
GPU NVIDIA
    ↓
pilote NVIDIA
    ↓
NVIDIA Container Toolkit
    ↓
CDI
    ↓
Podman
    ↓
conteneur
    ↓
Ollama
C’est précisément cette chaîne qui m’a posé problème.
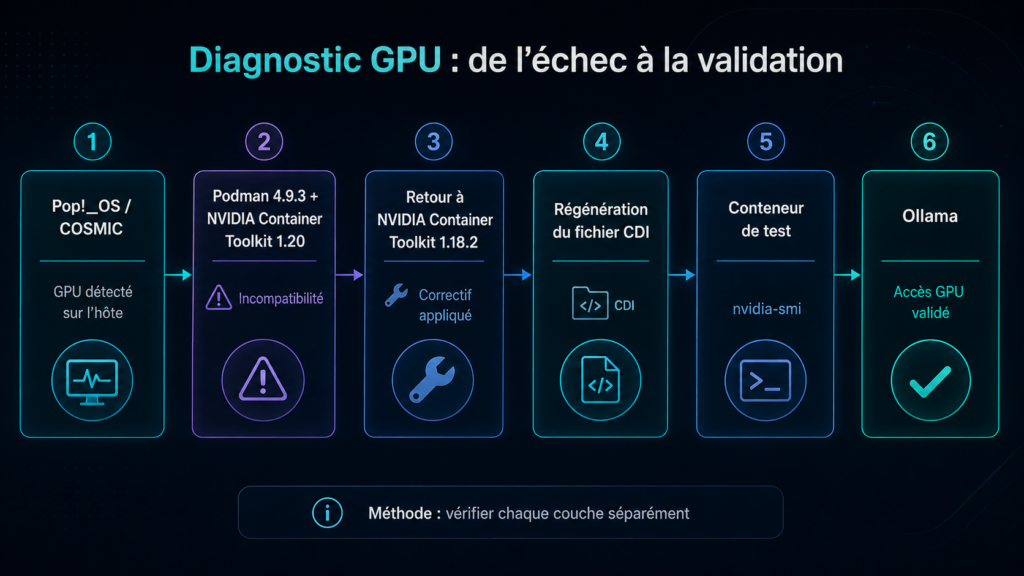
Podman 4.9.3 et NVIDIA Container Toolkit 1.20 : première impasse
J’avais installé NVIDIA Container Toolkit 1.20.0 avec Podman 4.9.3.
Le GPU était parfaitement visible sur l’hôte, mais Podman n’arrivait pas à résoudre correctement le périphérique CDI NVIDIA. Le symptôme se situait donc après le pilote et avant l’application.
Le point important n’était pas de modifier Ollama au hasard. J’ai d’abord réduit le problème à son niveau le plus bas : faire voir le GPU à un conteneur indépendant d’Ollama et d’Open WebUI.

Revenir à NVIDIA Container Toolkit 1.18.2
La configuration qui a finalement été validée sur cette machine utilise NVIDIA Container Toolkit 1.18.2.
Après le retour à cette version, j’ai régénéré le fichier CDI persistant :
sudo nvidia-ctk cdi generate --output=/etc/cdi/nvidia.yamlDeux fichiers CDI ont ensuite été observés :
/etc/cdi/nvidia.yaml
/var/run/cdi/nvidia.yaml
Le fichier important pour ma configuration persistante est :
/etc/cdi/nvidia.yamlLa version CDI générée et validée était :
cdiVersion: 0.5.0Cette correction a été déterminante. Le GPU n’était pas le problème, le pilote NVIDIA non plus : c’était bien la couche d’intégration entre Podman et NVIDIA qui devait être corrigée.
Valider CUDA dans un conteneur avant Ollama
Avant d’installer un modèle, j’ai testé directement l’exposition du GPU au conteneur.
La forme utilisée par ma configuration Podman repose sur CDI :
podman run --rm \
  --security-opt=label=disable \
  --device=nvidia.com/gpu=all \
  <image-cuda-nvidia> \
  nvidia-smi
Je conserve volontairement ici <image-cuda-nvidia> comme identifiant générique : l’image exacte utilisée pendant le test n’est pas nécessaire à la compréhension de l’architecture et je préfère ne pas documenter une référence que je n’ai pas conservée avec certitude.
Ce test est beaucoup plus important qu’il n’en a l’air.
Il valide séparément :
- le pilote sur l’hôte ;
- NVIDIA Container Toolkit ;
- CDI ;
- Podman ;
- l’accès réel au GPU depuis un conteneur.
Ce n’est qu’après cette validation que j’ai intégré Ollama.
Déployer Ollama avec accès GPU
La stack Ollama est stockée dans :
/srv/homelab/stacks/ai/ollamaLes modèles et données d’Ollama restent sur l’hôte dans :
/srv/homelab/data/ollamaLe principe du Compose final est le suivant :
services:
  ollama:
    # image Ollama définie dans la stack
    restart: "no"

    ports:
      - "127.0.0.1:11434:11434"

    volumes:
      - /srv/homelab/data/ollama:/root/.ollama

    devices:
      - nvidia.com/gpu=all

    security_opt:
      - label=disable

    networks:
      - ai-net

networks:
  ai-net:
    external: true
Je ne reproduis pas ici une balise d’image ou d’autres options qui ne sont pas nécessaires au récit si elles ne sont pas confirmées dans mes notes. Les éléments ci-dessus sont ceux qui structurent réellement l’installation finale : persistance, GPU CDI, réseau dédié et absence de redémarrage automatique.
Premier modèle : qwen3:1.7b
Pour cette GTX 1650 de 4 Go, j’ai retenu qwen3:1.7b comme premier modèle de travail.
L’objectif n’était pas de faire tourner le plus gros modèle possible, mais de disposer d’un modèle suffisamment léger pour valider l’ensemble de la chaîne locale : stockage, téléchargement, chargement, génération et utilisation du GPU.
Ajouter Open WebUI
Une fois Ollama opérationnel, j’ai ajouté Open WebUI pour disposer d’une interface web locale.
La stack se trouve dans :
/srv/homelab/stacks/ai/open-webuiet ses données persistantes dans :
/srv/homelab/data/open-webuiLe principe du Compose final est :
services:
  open-webui:
    # image Open WebUI définie dans la stack
    restart: "no"

    ports:
      - "127.0.0.1:3000:8080"

    volumes:
      - /srv/homelab/data/open-webui:/app/backend/data

    environment:
      OLLAMA_BASE_URL: http://ollama:11434

    networks:
      - ai-net

networks:
  ai-net:
    external: true
Le port d’Open WebUI reste lié à l’interface locale :
127.0.0.1:3000De la même manière, Ollama est exposé localement sur :
127.0.0.1:11434Pourquoi host.containers.internal n’a pas été ma solution finale
Au début, j’ai essayé de faire joindre Ollama par Open WebUI via l’hôte, avec une adresse basée sur :
host.containers.internalCette voie ajoutait une étape inutile : le trafic sortait du réseau logique des conteneurs pour repasser par l’hôte avant de rejoindre un service qui se trouvait lui aussi dans Podman.
Dans ma configuration, cette approche a posé un problème de connexion.
Plutôt que d’ajouter des correctifs autour de cette résolution, j’ai choisi une architecture plus directe.
ai-net : faire communiquer les conteneurs directement
J’ai créé un réseau Podman dédié à la pile IA :
podman network create ai-netLes deux stacks utilisent ce réseau externe.
Ollama y porte directement son nom de service, ce qui permet à Open WebUI d’utiliser :
http://ollama:11434comme URL de connexion.
Cette modification a simplifié toute l’architecture :
Open WebUI
     │
     │ ai-net
     ▼
   Ollama
     │
     ▼
NVIDIA GPU
Plus besoin de passer par host.containers.internal pour faire communiquer deux services qui appartiennent au même environnement.
C’est une correction technique, mais aussi une amélioration de conception : quand deux conteneurs doivent se parler, un réseau dédié est souvent plus clair que l’utilisation indirecte de l’hôte.
L’architecture finale de mon IA locale
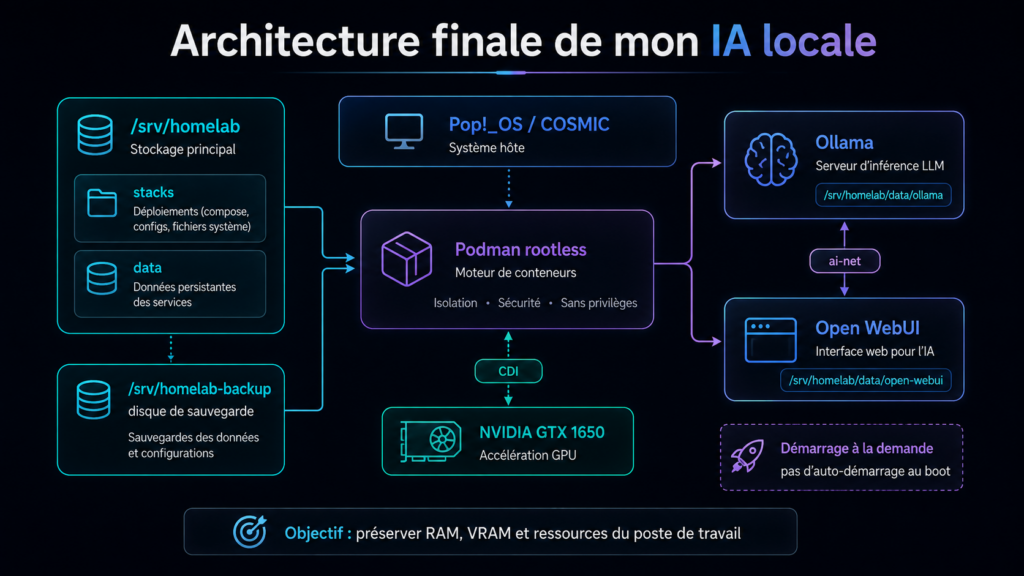
Après les essais, les erreurs et les corrections, l’architecture finale est devenue relativement simple.

Pop!_OS / COSMIC
│
├── Podman rootless
│   │
│   ├── Ollama
│   │   ├── /srv/homelab/data/ollama
│   │   └── NVIDIA GPU via CDI
│   │
│   └── Open WebUI
│       └── /srv/homelab/data/open-webui
│
├── ai-net
│   ├── Ollama
│   └── Open WebUI
│
├── /srv/homelab
│   ├── stacks
│   ├── data
│   └── containers
│
└── /srv/homelab-backup
Les composants remplissent chacun un rôle précis :
- Pop!_OS / COSMIC reste le système de mon poste de travail ;
- Podman rootless exécute les conteneurs ;
/srv/homelab/stackscontient les définitions Compose ;/srv/homelab/datacontient les données persistantes ;/srv/homelab/containerscontient le stockage rootless de Podman ;- CDI expose la GTX 1650 aux conteneurs ;
- Ollama fournit le moteur d’inférence ;
- Open WebUI fournit l’interface ;
ai-netrelie directement les deux services ;/srv/homelab-backupreçoit la stratégie de sauvegarde du Homelab.
Un choix final important : ne rien démarrer automatiquement
Au début du projet, l’idée d’un service toujours disponible pouvait sembler logique.
Mais ma machine n’est pas un serveur dédié. C’est aussi mon poste de travail.
Avec seulement 4 Go de VRAM sur la GTX 1650, je préfère que Firefox, COSMIC et mes autres applications disposent des ressources nécessaires lorsque je ne travaille pas avec l’IA.
J’ai donc retenu :
restart: "no"pour Ollama comme pour Open WebUI.
Les conteneurs ne démarrent pas automatiquement au boot.
Je les lance lorsque j’en ai besoin depuis Podman Desktop, puis je peux les arrêter lorsque la session d’IA est terminée.
Ce choix présente un avantage supplémentaire : toute l’infrastructure reste reproductible et persistante sans imposer une consommation permanente de RAM et de VRAM.
Ce que cette installation m’a appris
Une version plus récente n’est pas toujours la meilleure dans une configuration donnée
NVIDIA Container Toolkit 1.20 était plus récent que 1.18.2, mais la combinaison réellement validée avec mon Podman 4.9.3 est celle qui utilise Toolkit 1.18.2 et un fichier CDI régénéré.
Je préfère documenter l’état qui fonctionne réellement plutôt que supposer qu’une version plus récente est nécessairement meilleure.
Tester les couches une par une change complètement le diagnostic
La progression correcte a été :
nvidia-smi sur l’hôte
        ↓
CDI
        ↓
GPU dans un conteneur
        ↓
Ollama
        ↓
réseau ai-net
        ↓
Open WebUI
Si j’avais commencé directement par Open WebUI, j’aurais pu confondre une erreur réseau, une erreur Ollama et une erreur GPU.
En testant chaque couche indépendamment, le problème devient beaucoup plus facile à localiser.
Le réseau le plus simple a finalement été le meilleur
Faire passer Open WebUI par host.containers.internal ajoutait une abstraction dont je n’avais pas besoin.
Le réseau ai-net permet aux conteneurs de communiquer directement, avec :
http://ollama:11434C’est plus lisible et plus proche de l’architecture réelle.
Un Homelab local doit respecter son usage réel
Sur un serveur dédié, l’auto-démarrage des services est généralement naturel.
Sur mon poste de travail, ce serait une mauvaise optimisation.
La meilleure architecture n’est donc pas seulement celle qui fonctionne techniquement. C’est celle qui correspond à la machine sur laquelle elle tourne.
Conclusion
Cette installation a commencé comme un simple objectif : faire tourner Ollama et Open WebUI avec une GTX 1650.
Elle m’a finalement obligé à travailler sur plusieurs niveaux du Homelab :
- le stockage ;
- Podman rootless ;
- l’intégration NVIDIA ;
- CDI ;
- le diagnostic GPU ;
- les volumes persistants ;
- le réseau entre conteneurs ;
- la consommation des ressources du poste de travail.
L’environnement final n’est pas spectaculaire par sa complexité. C’est précisément ce que je recherchais.
J’ai maintenant une IA locale que je peux démarrer à la demande, avec ses données conservées sous /srv/homelab, une communication directe entre Open WebUI et Ollama, et une accélération GPU validée depuis les conteneurs.
La principale leçon de cette construction est devenue une règle générale pour mon Homelab : séparer les couches, les tester une par une, puis simplifier l’architecture dès qu’une abstraction n’apporte plus rien.